I fredags, den 30 oktober, meddelade Google, Microsoft och OpenAI att de ska följa en gemensam signal i robots.txt för AI-träning, och Anthropic, vars medarbetare Kevin Kelley skrivit förslaget till IETF, har redan börjat bygga in stödet i sin crawler. Jag såg det först i ett inlägg av Tony Hammarlund, som sammanfattade det klokare än de flesta, och jag har sedan läst på i de källor som finns längst ner. I stället för att blockera varje AI-bolags crawler för sig räcker det då med två rader:
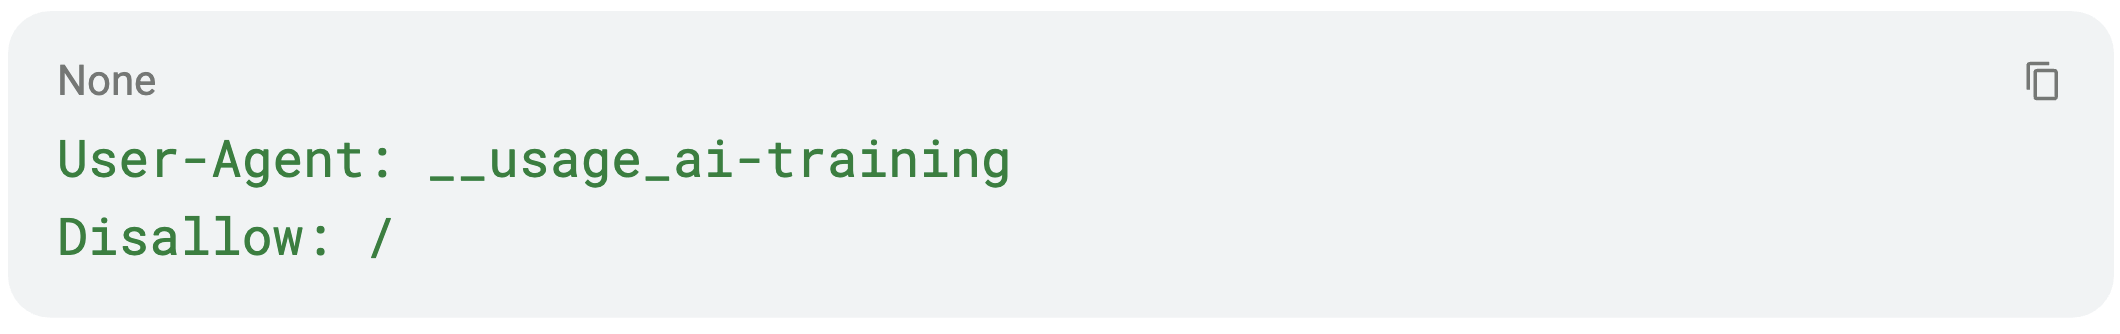
Det är första gången de stora AI-bolagen går ihop om ett sätt att begränsa träning men ändå tillåta crawl, och signalen gäller bara träning av AI-modeller så din synlighet i vanligt sök påverkas inte. En detalj som är lätt att missa är att den vanliga User-Agent: * inte räknas, signalen måste ha en egen grupp i filen för att gälla.
Men det finns fyra saker som är bra att veta innan du börjar ändra i din robots.txt.
Den gäller ingenstans än
Google börjar tidigt 2027, Bing den 1 februari 2027 och OpenAI någon gång under de kommande månaderna. Anthropic är de enda som redan har den igång. Fram till dess gäller de regler du redan har, och det är värt att komma ihåg att signalen är en preferens och inget avtal, den är frivillig, saknar sätt att tvinga fram efterlevnad och påverkar inte innehåll som redan har samlats in.
Den stänger inte ute AI-tjänsterna
Signalen gäller bara träning och är enligt förslaget uttryckligen inte en spärr mot crawling. När någon ber ChatGPT om något och den hämtar din sida i stunden gör den det som ChatGPT-User, och där skriver OpenAI själva att robots.txt-regler kanske inte gäller alls. Microsoft har däremot valt att skilja på träning och det de kallar grounding, alltså när Bing hämtar innehåll för att svara på en fråga, och de inställningarna görs separat i Bing Webmaster Tools.
Gemini är undantaget
Hos Google styr Google-Extended både träning och synlighet i Geminis svar. Om du blockerar träning med den nya signalen utan att nämna Google-Extended tolkar Google det som att du nekar även den, och då försvinner du också ur Gemini. Vill du synas där behöver du uttryckligen tillåta Google-Extended, men då får Google också träna, så hos Google går det i praktiken inte att få båda.
Meta är inte med
Bolaget som samma dag lät nya kommersiella villkor träda i kraft, där de ger sig själva rätten att crawla annonsörers sajter, har inte lovat att följa signalen. Det är kanske inte så förvånande, men det är värt att veta om du annonserar där.
Min take
Jag tycker att det är bra att vi får ett gemensamt sätt att säga hur vi vill att vårt innehåll ska användas, och det är bättre än att hålla på och jaga bottar en och en. Men signalen skyddar mindre än den låter. Nate Hake, som själv deltar i standardarbetet kritiserar att förslaget i princip undantar allt som en användare gör, vilket betyder att så fort någon ber en AI om något gäller inte signalen längre. Detta verkar vara viss del ett spel för galleriet, ett sätt att få sajtägare att låta bli att blockera bolagens bottar helt.
För de flesta företag vi jobbar med här i Dalarna tror jag ändå att den viktigare frågan är en annan. Ditt innehåll finns till för att bli hittat, och om dina kunder allt oftare ställer sina frågor till en AI i stället för till Google är det svårt att se varför du skulle vilja försvinna därifrån. För en tidning, en författare eller ett kunskapsföretag som lever på sitt innehåll ser kalkylen helt annorlunda ut, och där kan det vara helt rätt att neka träning även om det kostar lite synlighet.
Det du kan göra just nu är framförallt att bestämma dig för om du vill neka träning, synas i AI-svar eller båda, och skriva ner varför. Behåll de regler per crawler du redan har och vänta med att ändra tills signalen faktiskt används fullt ut, så hjälper vi gärna till när det är dags.